 AI音声合成(TTS)とは?


2026.05.26
導入事例

 対応言語
話者数
業界経験
導入実績
車載システムからゲーム機まで。
世界中で愛されるプロダクトに、私たちの音声技術が組み込まれています。

クラウド専業サービスや他社エンジンとは一線を画す、リードスピーカー独自の強みと価値。
価格・対応言語・セキュリティなど、選定に必要な比較ポイントや特長をまとめた資料をご用意しています。

Case Study
AI音声の実装によって、どのような課題解決と進化を実現できるのか。
業界・ユースケース別にご紹介します。
機器への組み込みから、ナレーション制作、Webの読み上げまで。用途に合わせてお選びいただけます。
機器に直接組み込む、
多言語対応のオフライン音声エンジン。
ネット接続なしで、数ミリ秒で発話します。
スレッドセーフ&マルチインスタンス完全対応
完全オフライン動作(通信ゼロ=低レイテンシ)
テキスト入力だけで、高品質なナレーション音声を作成。
収録・手配は不要です。
サイトをワンクリックで、PDFやWord等のドキュメントも音声化。
コード埋め込みだけで、運用の手間もかかりません。
ブランドイメージに合わせた、企業独自のAI音声を開発。
声質・話し方などご要望通りに作成します。
英語教育・研修向けの読み上げ/発音矯正ソフト。
自作の英文でもお手本音声を用意できます。
25年以上、私たちは人の声を扱ってきました。
日本国内の1800社以上に導入、日本のものづくりの現場に寄り添い続けています。
すべての音声は、許諾を得た声優の収録から。無断利用を防ぎ、TTSの利用者やお客様のデータを収集しない方針を貫いています。
完全オフライン動作で、データが機器の外に出ない構造。ISO/IEC 27001:2022基準や、GDPR基準に準拠しています。
25年以上、日本語の音声に向き合ってきました。身近な製品の"声"として、暮らしの中に溶け込んでいます。
ReadSpeaker製品は法人・団体向けに
ライセンス契約による販売をしております。
市販のソフトウェア製品としては流通しておりません。
製品について専任の営業担当より直接ご案内させていただきます。AI音声を作りたいがどうしたら良いか悩んでいるという場合でも是非お気軽にお問い合わせください。デジタルボイス専門ブランドとしてのノウハウに基づいてご相談させていただきます。

お客様がご検討されている、ご利用目的や導入規模についてヒアリングをさせていただきます。
内容によりまして直接お伺いして詳細をお打ち合わせさせていただいたり、デモをご覧いただいたりという場合もございます。
ヒアリングの内容をもとに御見積を算定いたします。
同時にお客様に最適な製品をご提供できますよう選定をお手伝いさせていただき、音声合成の導入手法もご一緒に検討させていただきます。
ご提案の内容、御見積に同意いただき、お客様からご発注後にReadSpeaker製品の納品となります。
ご発注までの間にご不明点はご納得いただけるまで何度でもご相談ください。
ご購入後一定期間は無償にてソフトウェア保守のサービスをご提供いたします。
それ以降は任意加入の有償ソフトウェア保守のサービスもご用意しております。保守のサービス内容および費用等は御見積とあわせましてご案内致します。※製品によって異なります。
(speechMaker Cloudの場合)
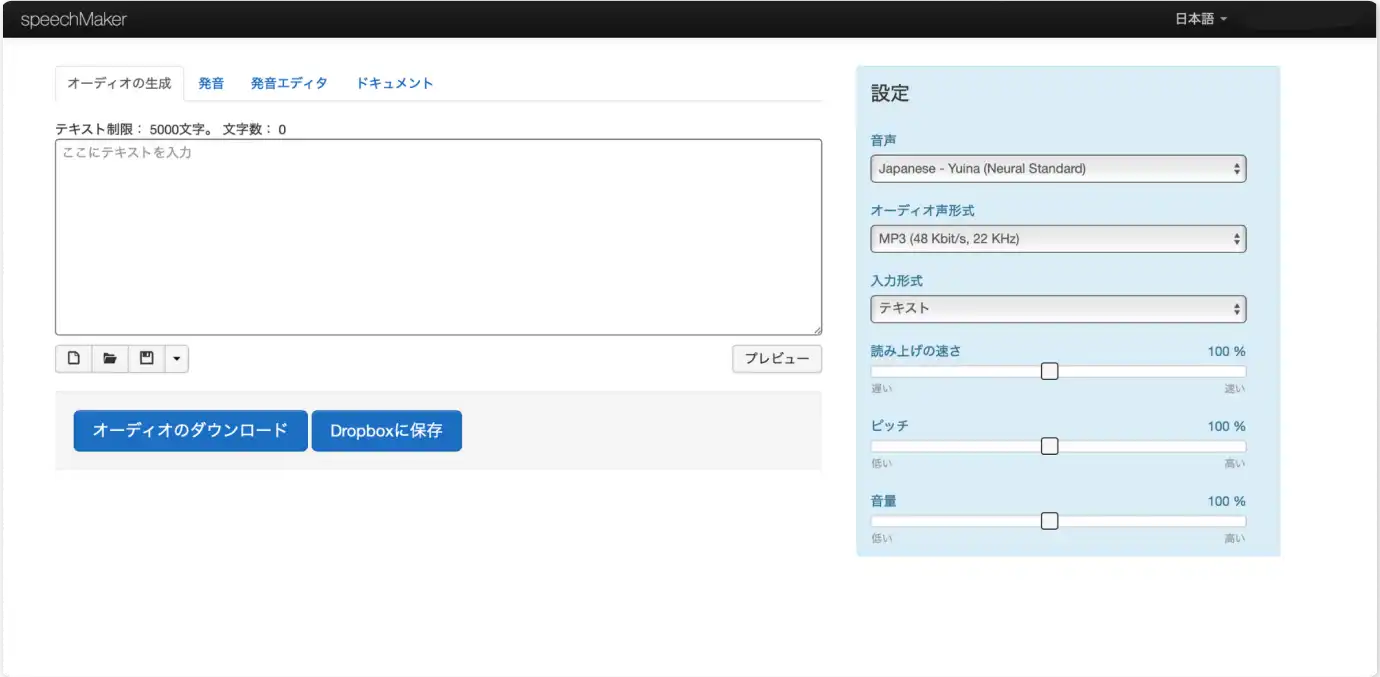
ブラウザにアクセス後、
契約したメールアカウントで
ログイン
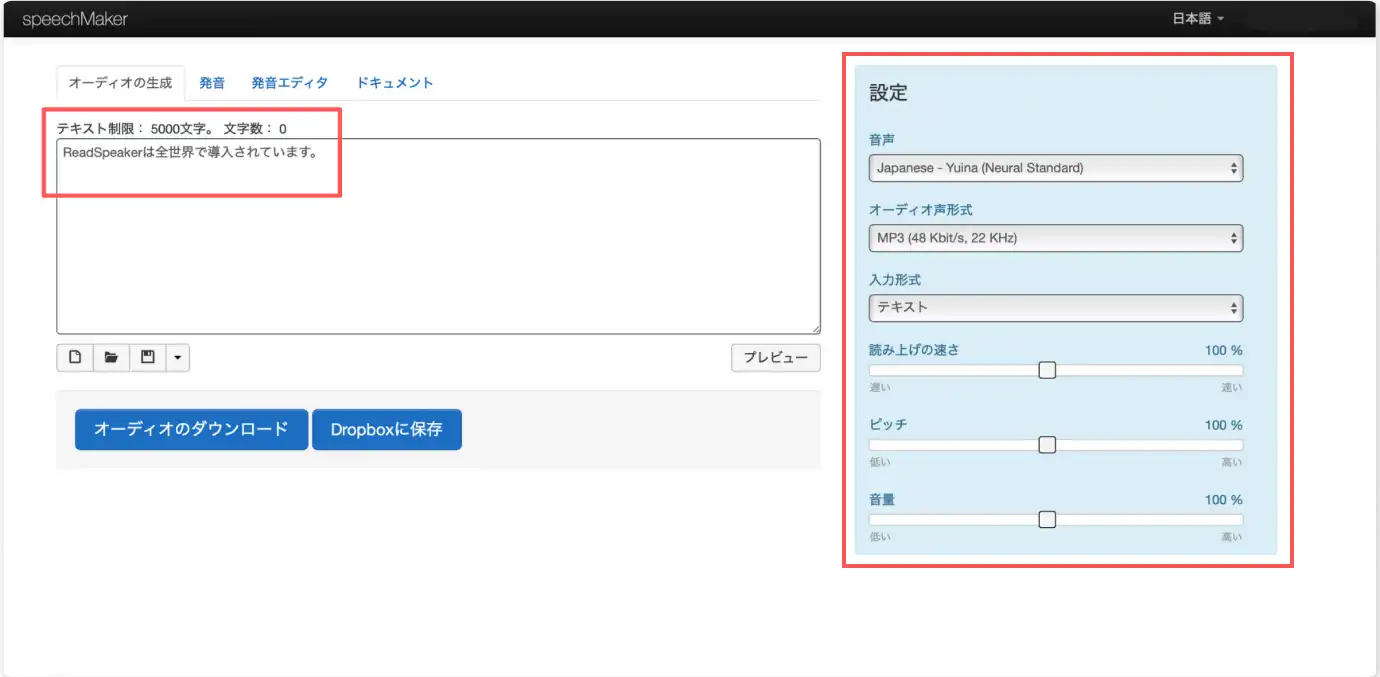
読み上げたいテキストを入力し、
プレビューを聞きながら
好みの音声に設定する
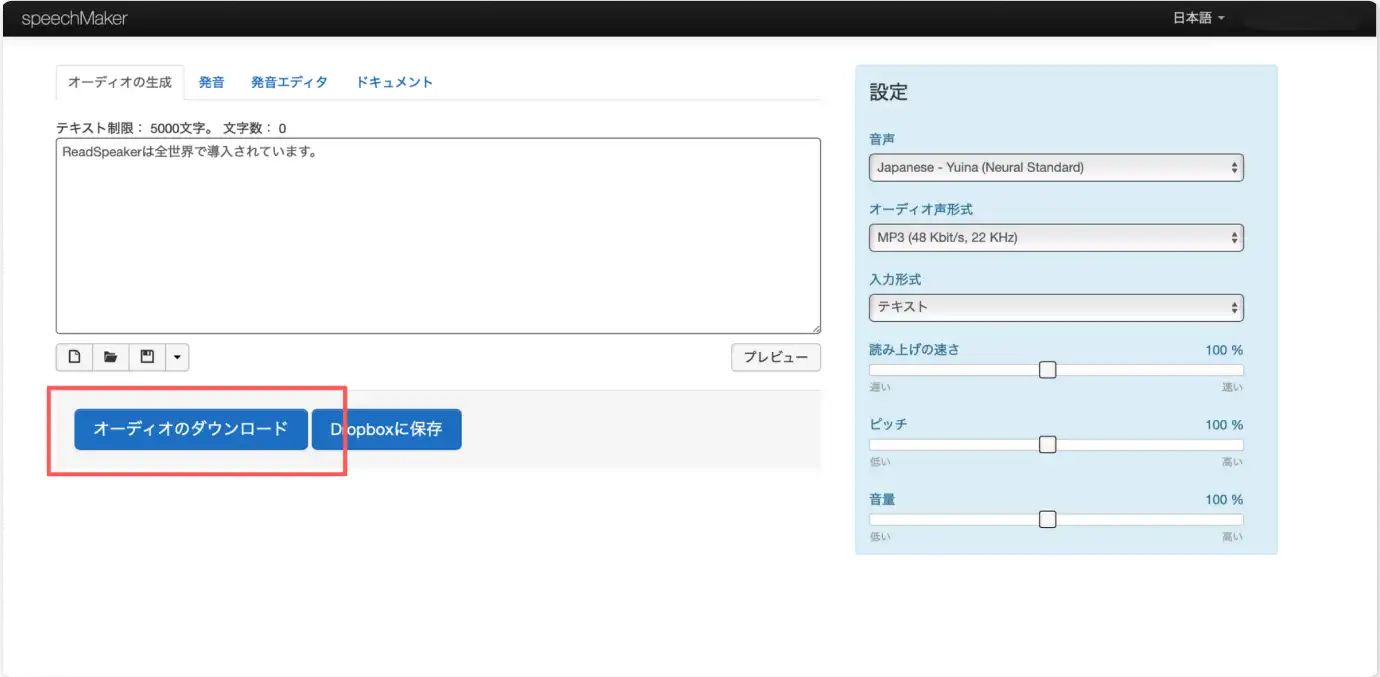
「オーディオのダウンロード」で
音声ファイル化
FAQ
 組込みSDKは、完全にオフラインで動作しますか?
 はい。ReadSpeakerの組込み音声エンジンは、機器の中だけで高品質な音声を生成します。ネット接続のない家電・ロボット・産業機器・IoT機器に適しています。
エンジンのサイズ(フットプリント)や動作に必要なメモリはどのくらいですか?
iOS・Android・組込みLinuxに対応し、1音声あたり約6〜35MB(その他OSは個別対応)です。動作に必要なメモリ要件の目安は、音声辞書データの構成によりROM最小9MB、低リソース環境向けの軽量プロファイル対応によりRAM最小20MBとなります。
同じ声を、機器・アプリ・クラウドで共通して使えますか?
はい。オリジナルボイスを含め、組込みSDK・API・アプリをまたいで同じ声を展開できます。追加のベンダーや別ソリューションを介する必要はありません。
規制の厳しい環境で、セキュリティとプライバシーは守られますか?
オフライン動作のため、データは機器の外に出ません。ISO/IEC 27001:2022基準や、GDPR基準に準拠しています。
組込みSDKの導入は難しくありませんか?
いいえ。speechEngine SDKは開発者向けAPI、SSML対応、充実したドキュメントを備えています。QNX・各種RTOSなどの対応もご相談いただけます。
他社のAI音声と何が違うのですか?
クラウド専業ベンダーと異なり、小さな容量で動く組込みオフライン音声を、90言語対応で提供します。開発から日本語サポートまで自社で完結します。
音声合成(Text-to-Speech, TTS)とは、テキスト(文字情報)を人間の声のような音声に変換する技術です。
スマートスピーカーの応答、カーナビの案内、駅や空港の自動アナウンス、読み上げアプリなど、私たちの生活のさまざまな場面で使われています。
近年はAI技術を活用することで、より自然で滑らかな読み上げが可能になっています。
あらかじめ録音した人間の声を細かい単位(音素や音節)に分け、それらをつなぎ合わせて音声を生成する方式です。
明瞭な音声を得られますが、文脈によってはイントネーションが不自然になったり、データ容量が大きい等の課題もあります。
大量の音声データとテキストをAI(人工知能)が学習し、声の高さ・リズム・抑揚などをモデル化します。録音データをそのままつなぐのではなく、ゼロから音声波形を生成するため、人間に近い自然な声質や感情豊かなイントネーションを実現できます。
特に近年は「ニューラルTTS(Neural Text-to-Speech)」が急速に進化し、自然さ・表現力ともに従来より大幅に向上しています。